Tables de routage
Temps de lecture10 minEn bref
Résumé de l’article
Dans cet article, vous apprendrez à stocker le résultat d’un parcours dans une structure de données appelée table de routage. Ensuite, vous apprendrez à utiliser cette structure pour retrouver le chemin trouvé par le parcours jusqu’à un sommet donné. Après la vidéo, nous établirons un lien entre les tables de routage et certaines structures de données que vous avez déjà vues.
Points clés à retenir
-
Les tables de routage permettent de stocker le résultat d’un parcours de graphe en mémoire.
-
Elles peuvent ensuite être utilisées pour analyser le parcours effectué, par exemple pour trouver un chemin.
-
Elles peuvent être implémentées à l’aide d’une liste ou d’un dictionnaire.
Contenu de l’article
Vidéo
Veuillez consulter la vidéo ci-dessous (en anglais, affichez les sous-titres si besoin). Nous fournissons également une traduction du contenu de la vidéo juste après, si vous préférez.
Information
Cliquez ici pour afficher la traduction de la vidéo.
Bonjour tout le monde ! Dans la leçon d’aujourd’hui, nous allons voir comment construire des tables de routage pour naviguer dans un graphe, en utilisant les arbres couvrants obtenus à partir d’algorithmes de parcours de graphe, tels que le BFS ou le DFS. Ces tables de routage aideront l’intelligence artificielle que vous développerez dans ce cours à se déplacer entre deux positions dans le labyrinthe.
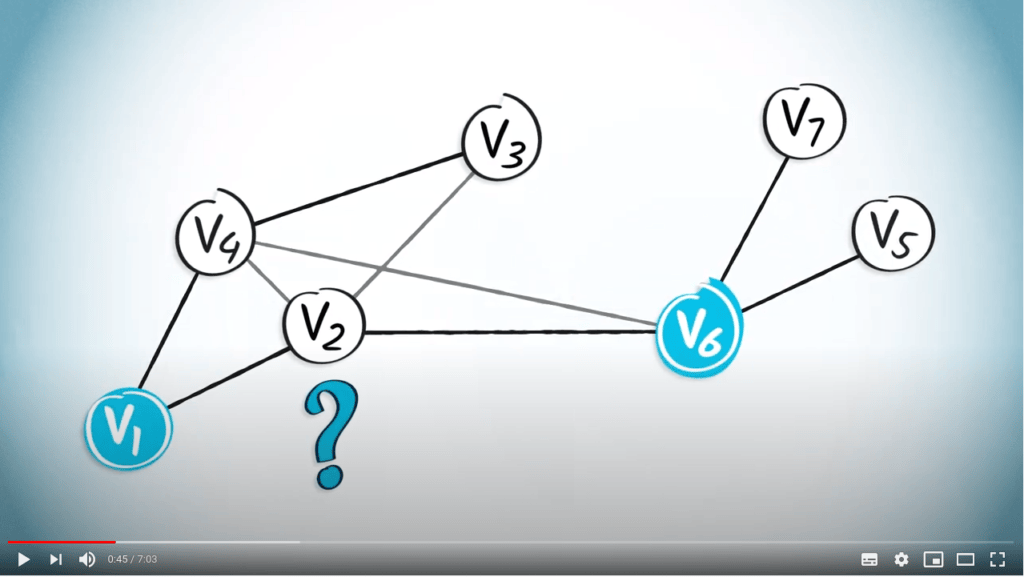
Dans la leçon précédente, vous avez appris à construire des arbres couvrants. Une fois que nous avons un tel arbre couvrant, nous avons besoin d’un algorithme de routage pour pouvoir naviguer entre n’importe quels deux sommets du graphe.
Le routage d’un point de départ à une destination est interprété à l’envers. Nous savons déjà quel est le point de départ, donc nous devons commencer par la destination pour trouver un chemin. Ainsi, un algorithme de routage fournit un chemin de la destination au point de départ.
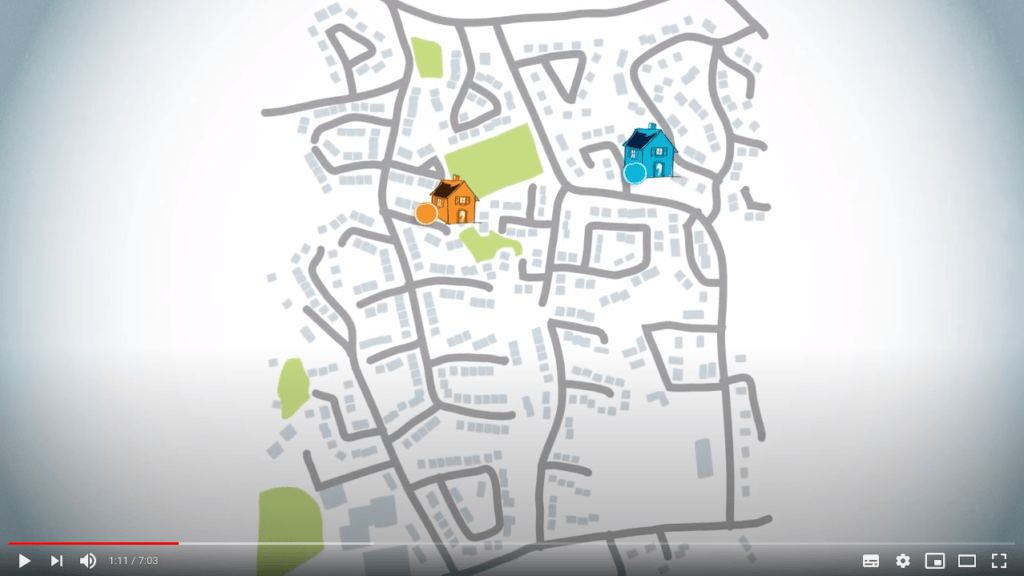
Tracer un chemin à l’envers est plus intuitif qu’il n’y paraît. Imaginez que vous, le cercle bleu sur la carte, devez conduire jusqu’à la maison d’un(e) ami(e), qui est le cercle orange sur la carte.
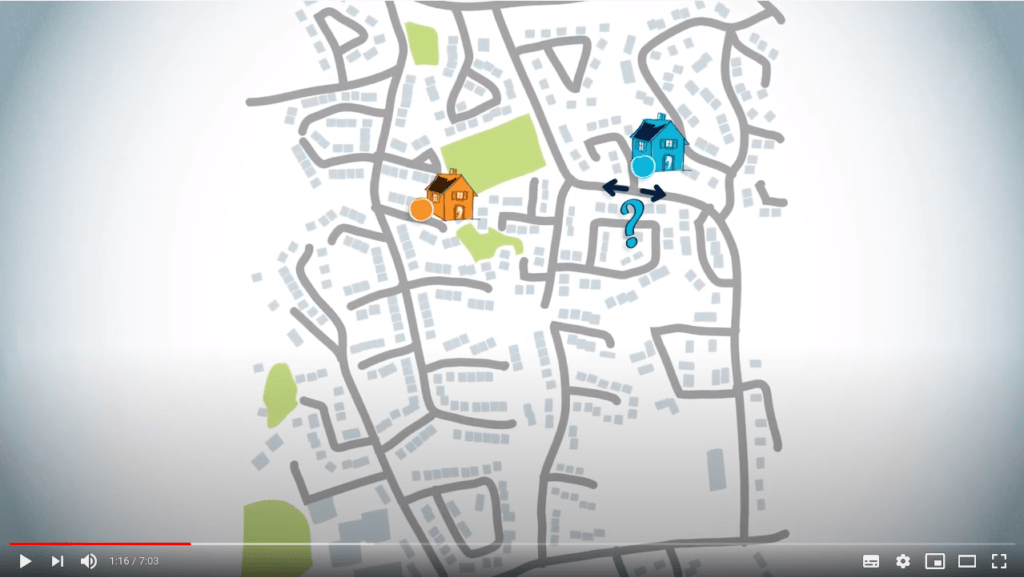
Vous pourriez commencer par décider si vous devez tourner à gauche ou à droite à la prochaine intersection.
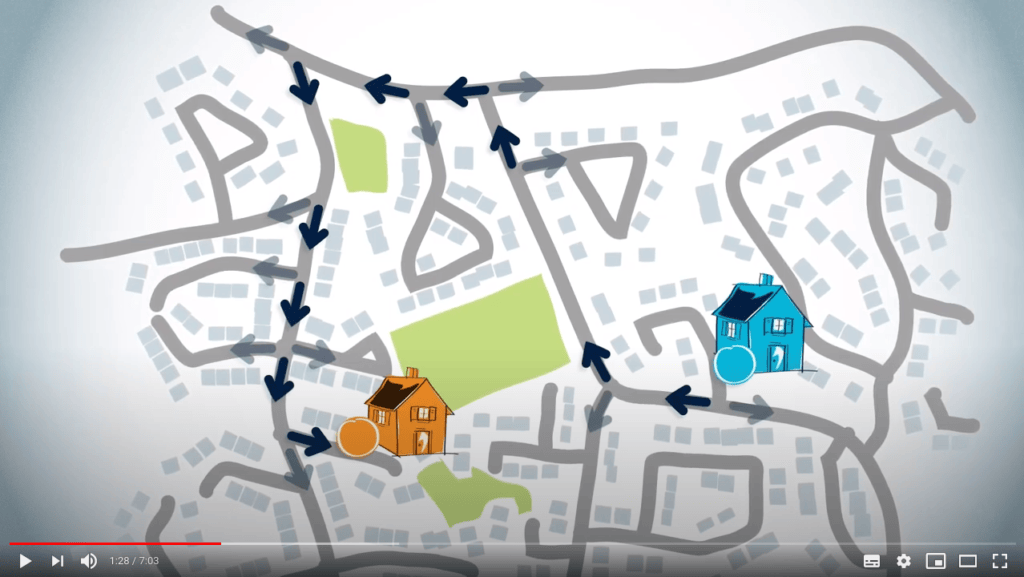
Ensuite, à chaque intersection que vous rencontrez, identifiez quelle route peut être empruntée ensuite, jusqu’à ce que vous atteigniez enfin la maison de votre ami(e).
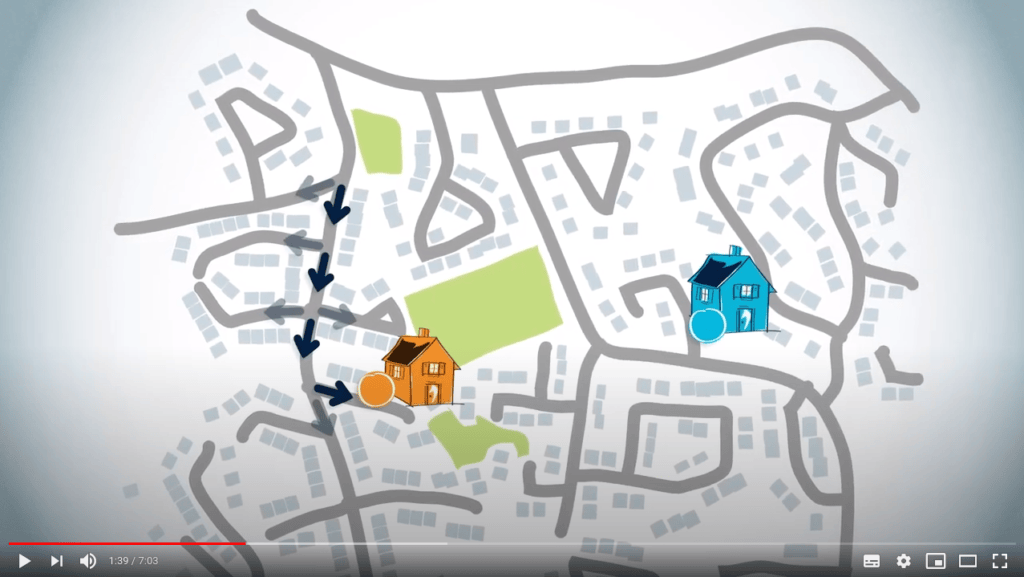
Ou, vous pourriez réfléchir au meilleur itinéraire à l’envers, en identifiant d’abord sur quelle rue se trouve la maison de votre ami(e). Ensuite, quelle autre route accède à cette rue, etc.
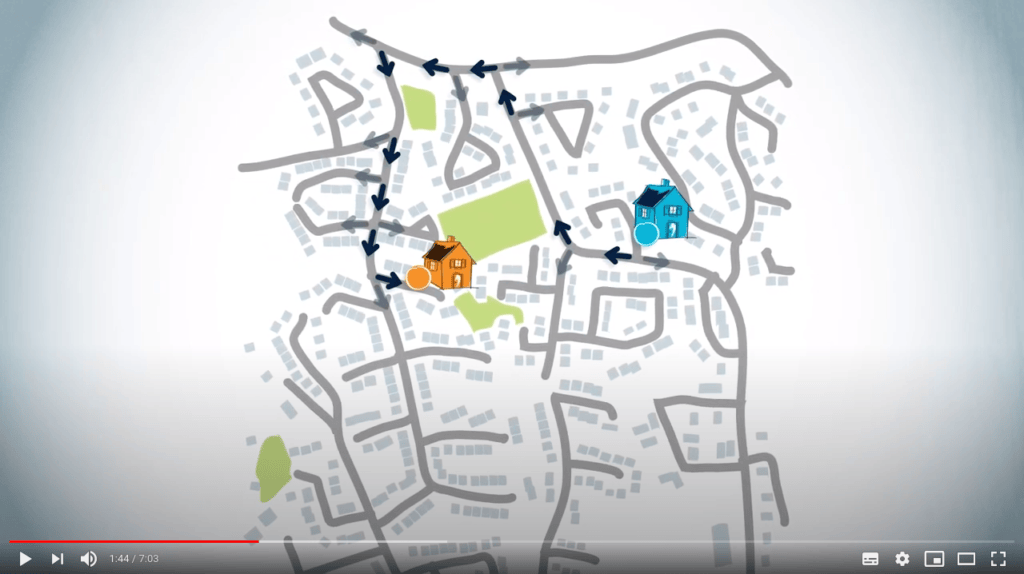
Jusqu’à savoir si vous devez tourner à gauche ou à droite à la prochaine intersection.
Cette seconde façon de penser est celle utilisée par l’algorithme de routage.
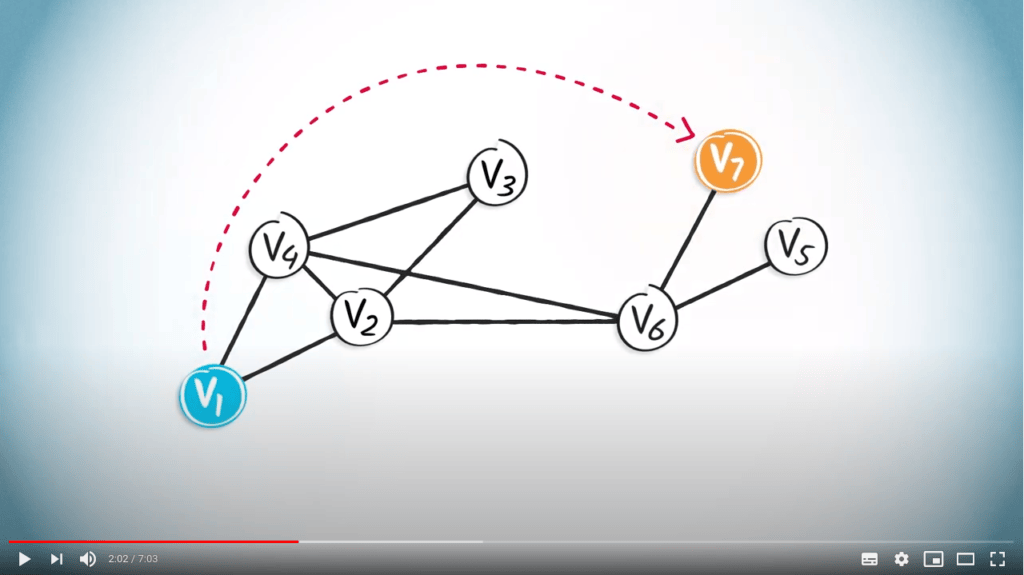
Pour mieux comprendre cela, regardons un exemple que nous avons déjà vu dans la leçon précédente avec Vincent. Considérons le chemin entre $v_1$ et $v_7$.
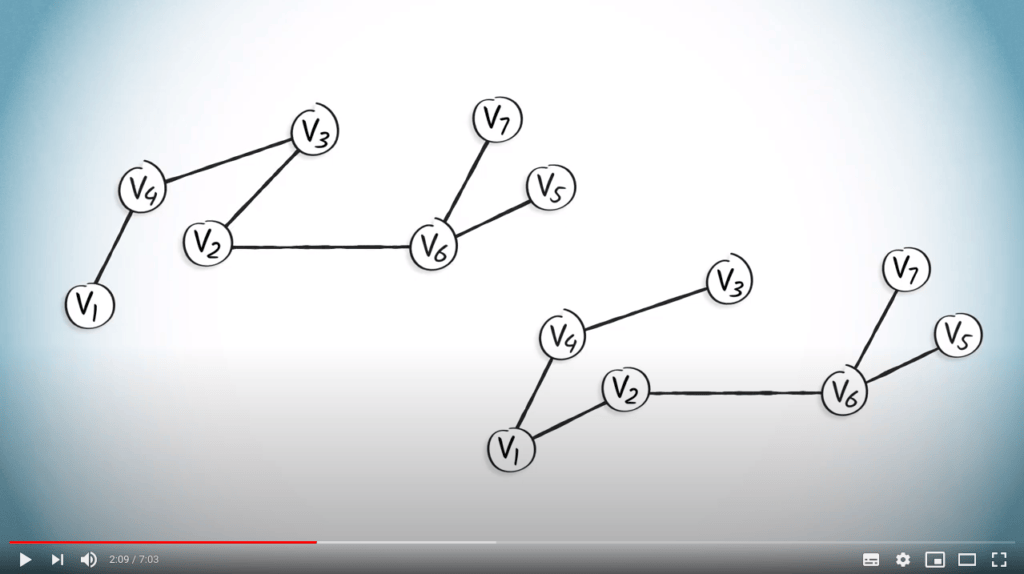
Nous pouvons voir l’arbre couvrant obtenu en utilisant un DFS à gauche, et l’arbre couvrant obtenu en utilisant un BFS à droite.
Le routage de $v_1$ à tout autre sommet peut être facile lorsque nous utilisons des arbres. Mais pour ce faire, nous avons d’abord besoin de quelques définitions supplémentaires.
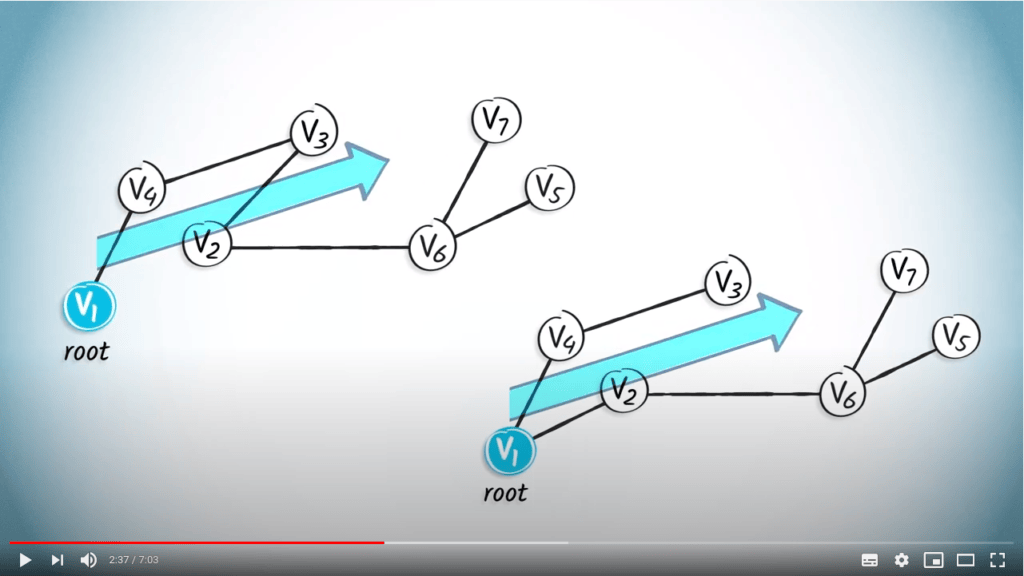
Un arbre enraciné est un arbre dans lequel nous désignons un sommet particulier comme racine, également parfois appelée origine. Dans ce cas, nous considérerons $v_1$ comme la racine, car c’est notre position de départ. Par conséquent, les arêtes de cet arbre enraciné ont une orientation naturelle s’éloignant de la racine.
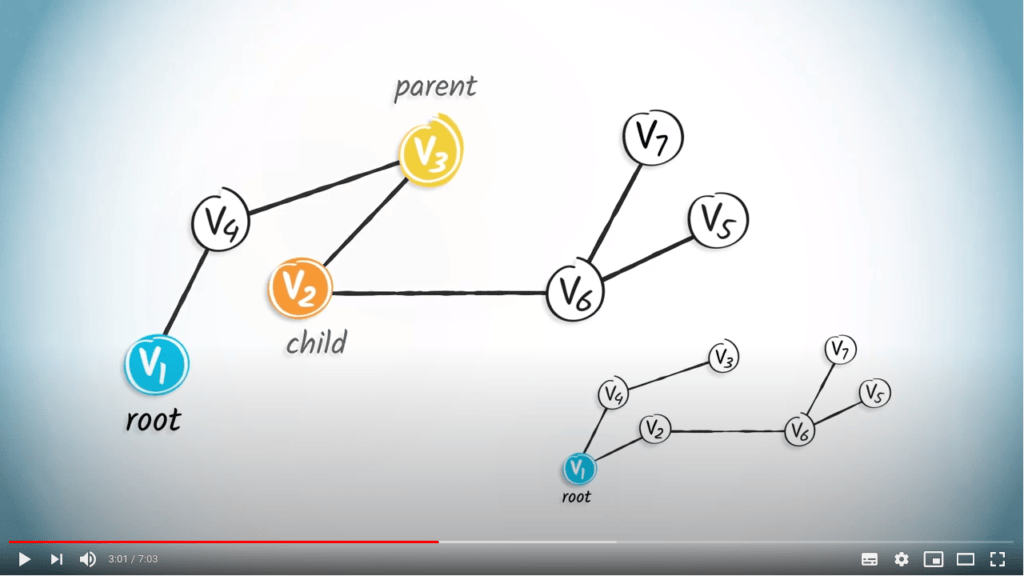
Dans un arbre enraciné, le parent d’un sommet est le sommet qui lui est connecté sur le chemin depuis la racine. Par exemple, le parent de $v_2$ est $v_3$ dans l’arbre de gauche. Chaque sommet, sauf la racine, a un seul parent. Un enfant d’un sommet $v$ est un sommet dont $v$ est le parent. Ainsi, $v_2$ est l’enfant de $v_3$ dans l’arbre de gauche.
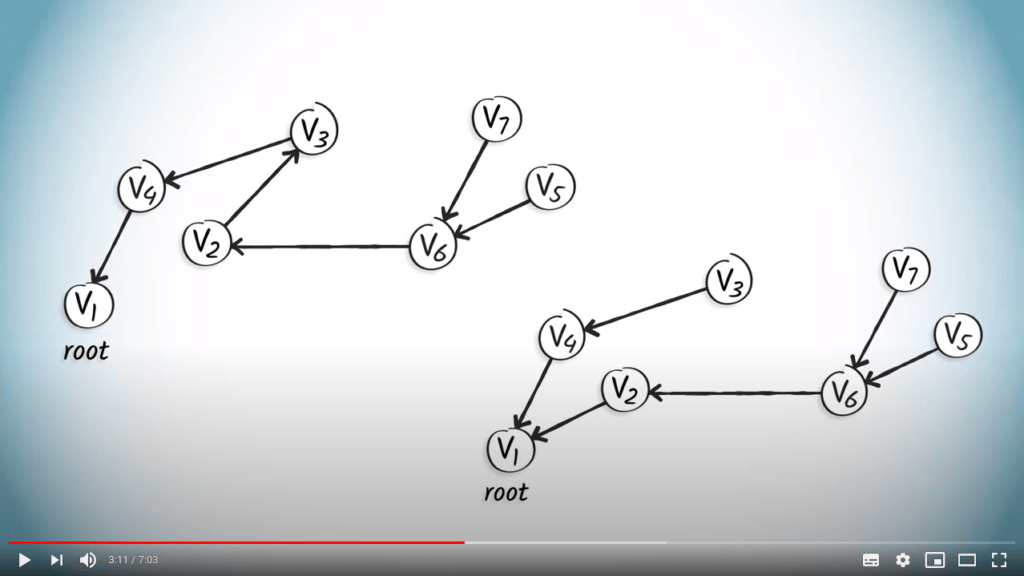
Si nous appliquons ces concepts à l’ensemble des arbres, nous obtenons les arbres enracinés suivants, où l’orientation des arêtes indique les parents des sommets. Par exemple, dans les deux graphes, $v_1$ n’a pas de parent, le parent de $v_4$ est $v_1$, et les enfants de $v_6$ sont $v_7$ et $v_5$.
Nous pouvons maintenant construire des tables de routage en considérant le parent de chaque sommet dans le chemin depuis $v_1$. Les tables de routage sont des structures de données utiles qui permettent de reconstruire un chemin. Comme mentionné précédemment, le routage est considéré à l’envers, de la destination jusqu’à la position de départ.
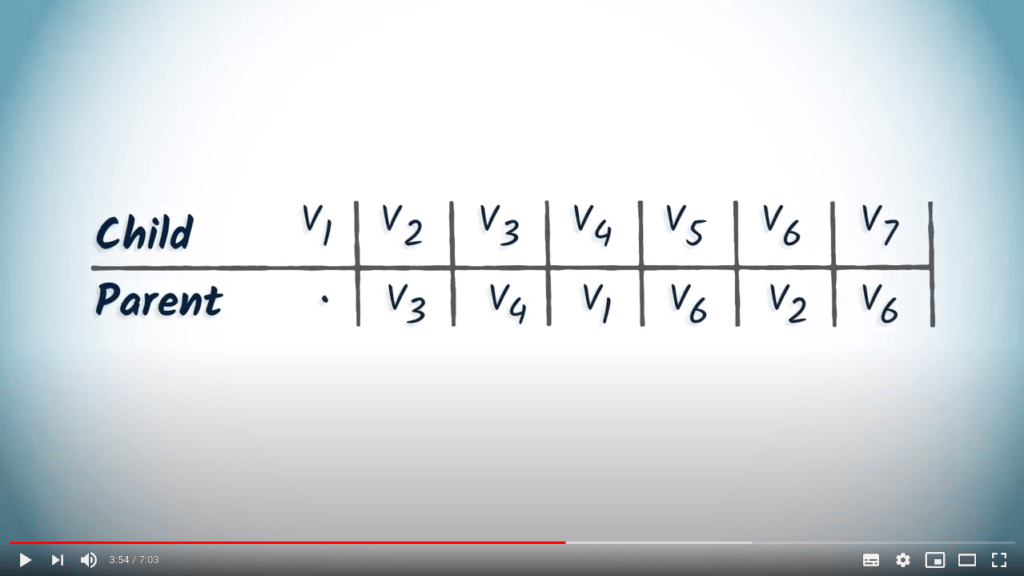
Une table de routage comporte une seule ligne et autant de colonnes qu’il y a de sommets dans le graphe. Chaque colonne correspond à un sommet, et la valeur associée dans la table est son parent dans l’arbre couvrant enraciné en $v_1$.
Voyons maintenant comment cette table est construite étape par étape à l’aide d’un arbre couvrant.
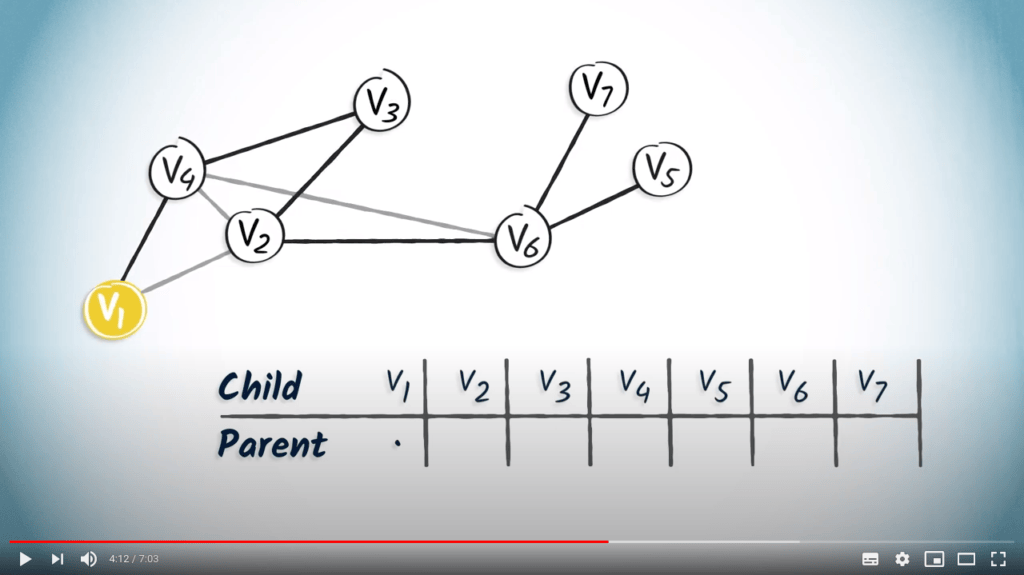
Commençons par un arbre obtenu à partir d’un DFS. Nous partons d’une table vide. Le sommet $v_1$ est la racine, donc il n’a pas de parent. Nous notons simplement un point dans la colonne de $v_1$.
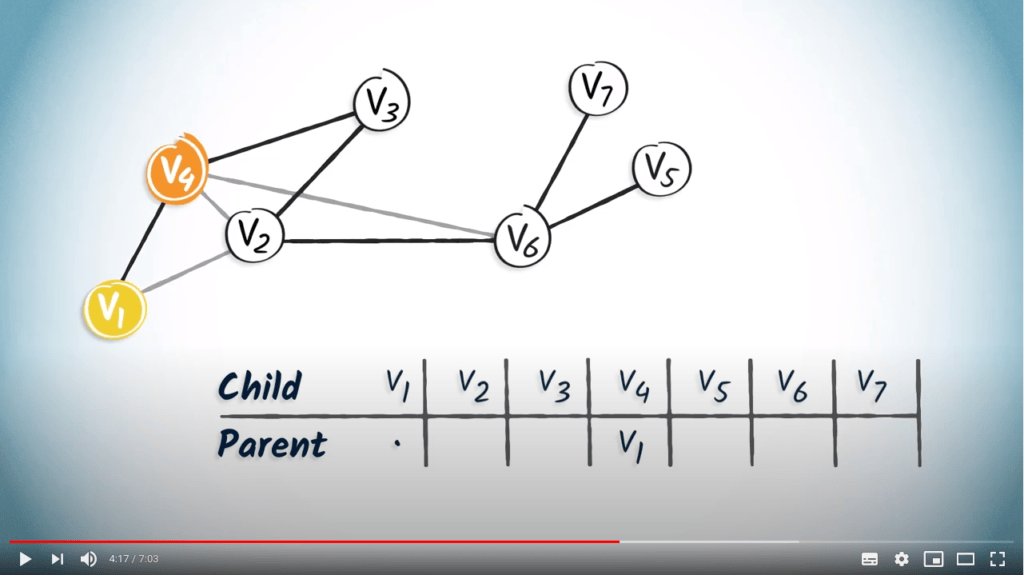
Le sommet $v_1$ n’a qu’un seul enfant, $v_4$. Nous ajoutons donc $v_1$ dans la colonne correspondant à $v_4$.
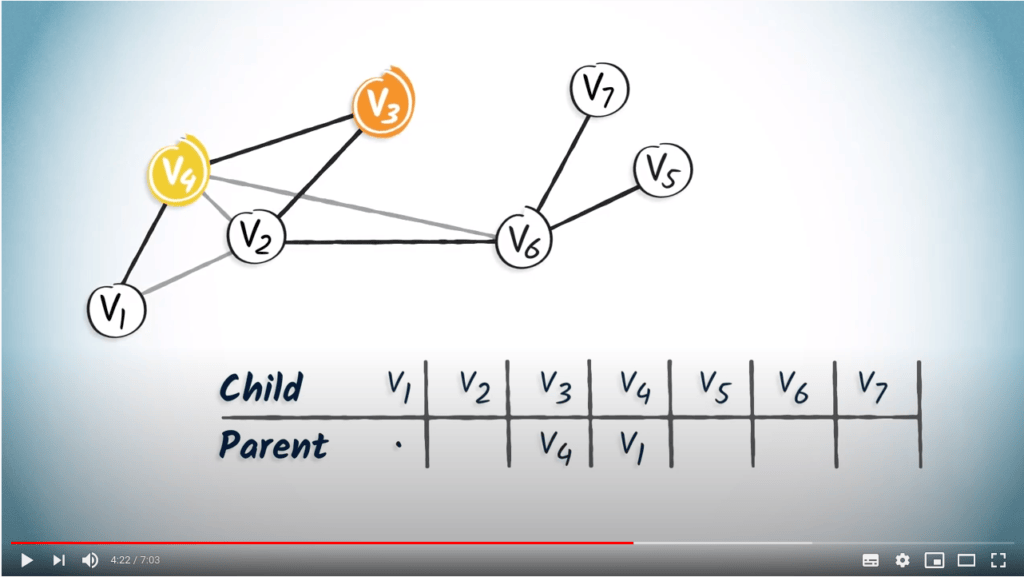
Le sommet $v_4$ n’a qu’un seul enfant, $v_3$. Nous ajoutons donc $v_4$ dans la colonne de $v_3$.
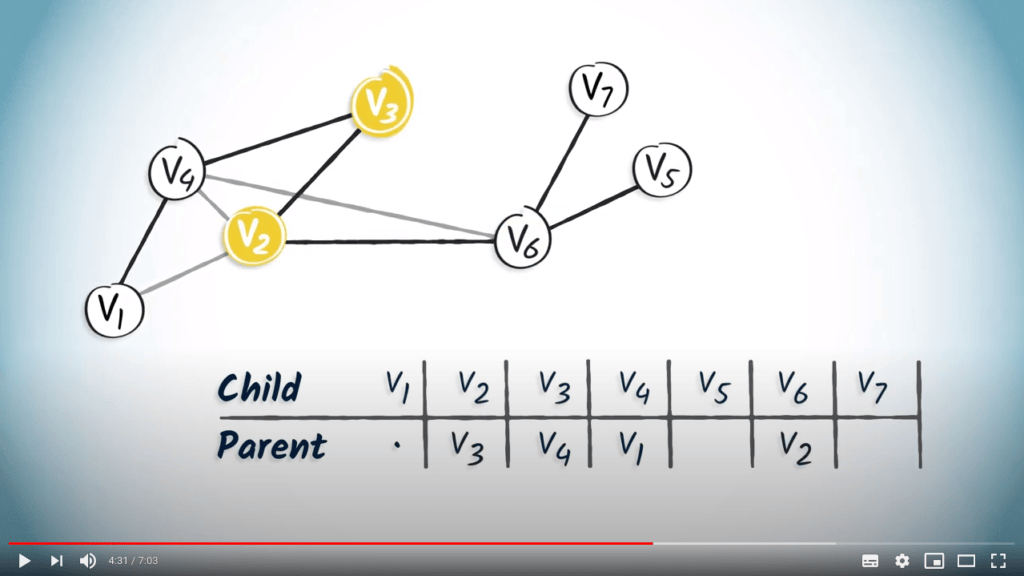
Appliquons maintenant le même principe aux sommets $v_2$ et $v_6$, qui sont les seuls enfants de $v_3$ et $v_2$, respectivement.
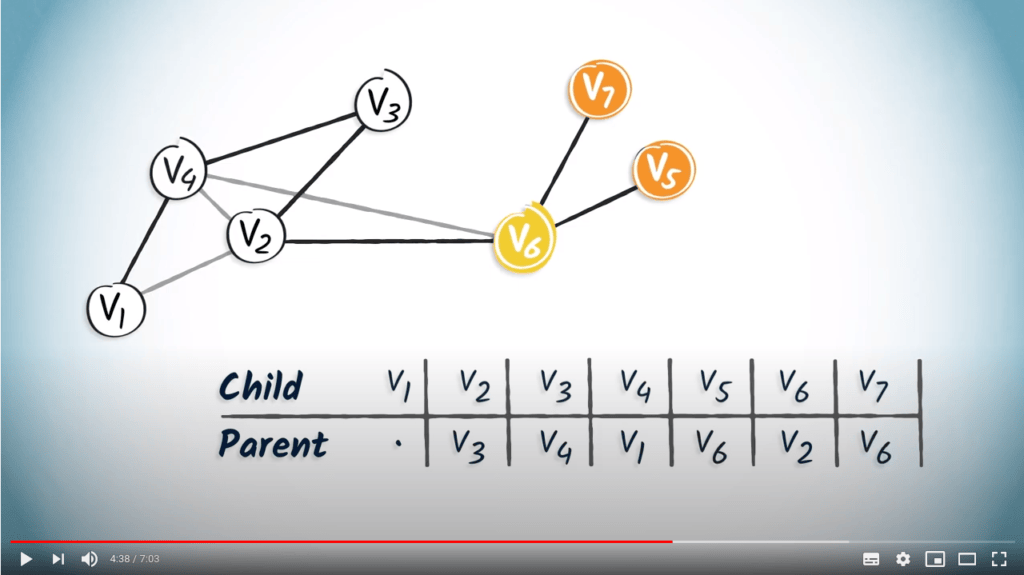
Enfin, $v_6$ a deux enfants, $v_7$ et $v_5$. Ajoutons donc $v_6$ dans les colonnes correspondant à $v_5$ et $v_7$. Voilà, la table de routage est complète.
Pour lire cette table, commencez simplement par la destination souhaitée et lisez l’entrée correspondante, qui fait référence au parent du sommet de destination.
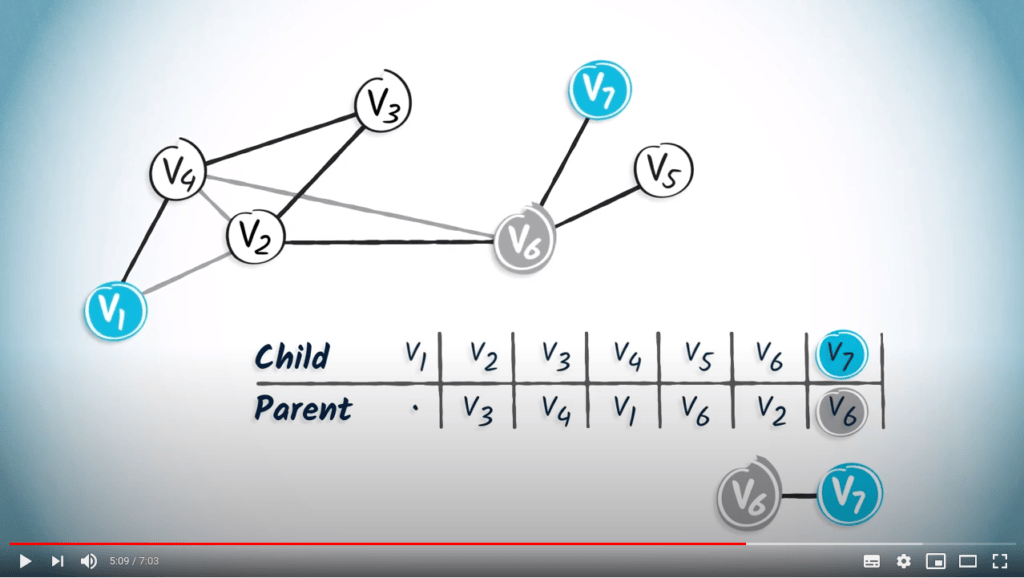
Par exemple, si nous cherchons le chemin de $v_1$ à $v_7$, nous lisons d’abord l’entrée correspondant à $v_7$, qui est $v_6$. Par définition, le parent de la destination correspond à son tour au sommet précédent dans le chemin de $v_1$ à la destination.
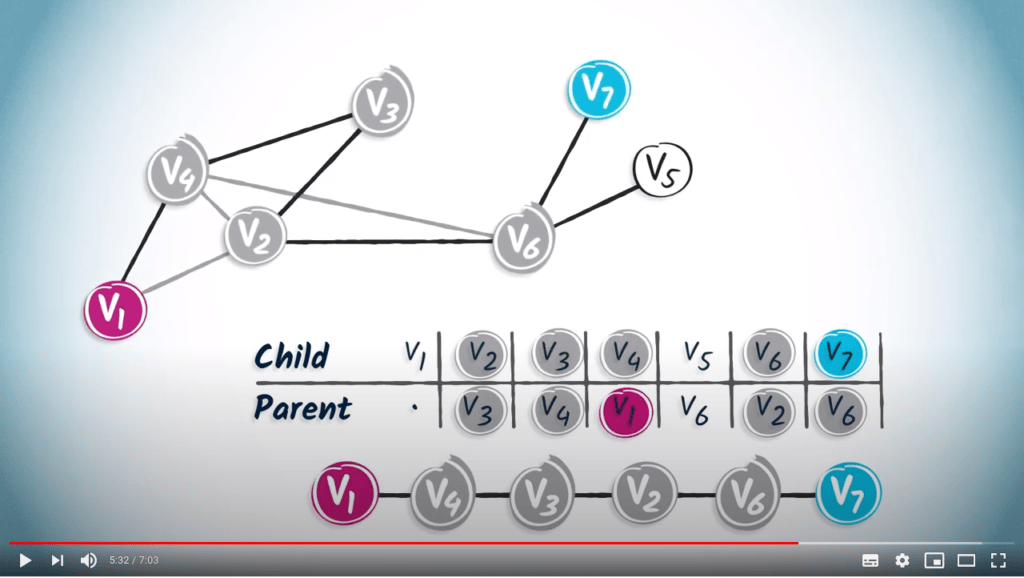
En lisant les entrées correspondant à chaque prédécesseur, vous atteindrez finalement la position de départ $v_1$. Dans notre exemple, l’étape suivante consiste à identifier l’entrée correspondant à $v_6$, qui est $v_2$. En continuant ainsi, nous obtenons le chemin $(v_7, v_6, v_2, v_3, v_4, v_1)$.
En guise de second exemple, construisons également la table de routage à partir de l’arbre couvrant obtenu par un BFS.
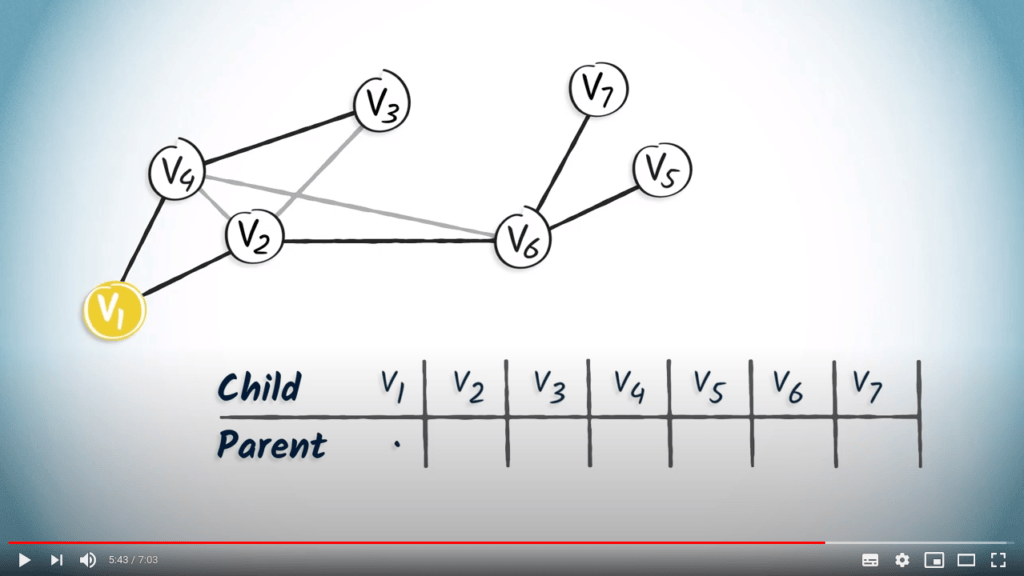
Voici l’arbre couvrant. Encore une fois, nous partons d’une table vide.
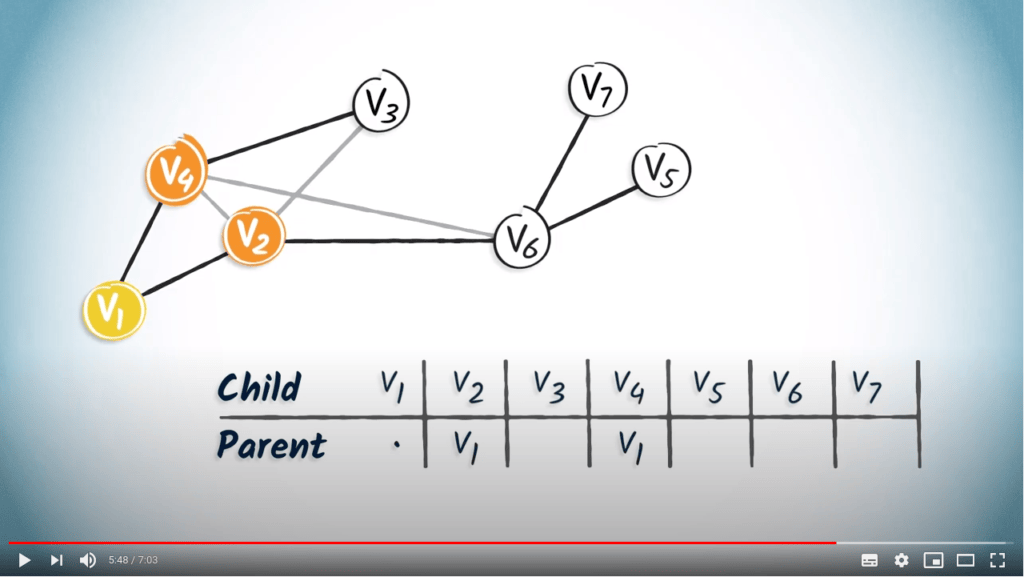
Le sommet $v_1$ a deux enfants, les sommets $v_4$ et $v_2$. Nous ajoutons donc $v_1$ dans les colonnes correspondantes.
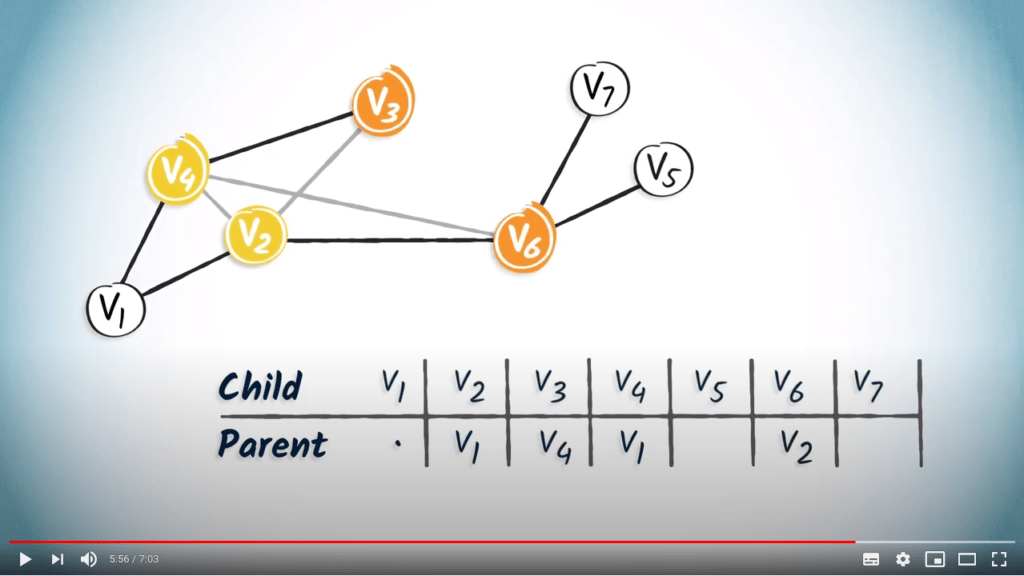
L’unique enfant de $v_4$ est $v_3$, et l’unique enfant de $v_2$ est $v_6$.
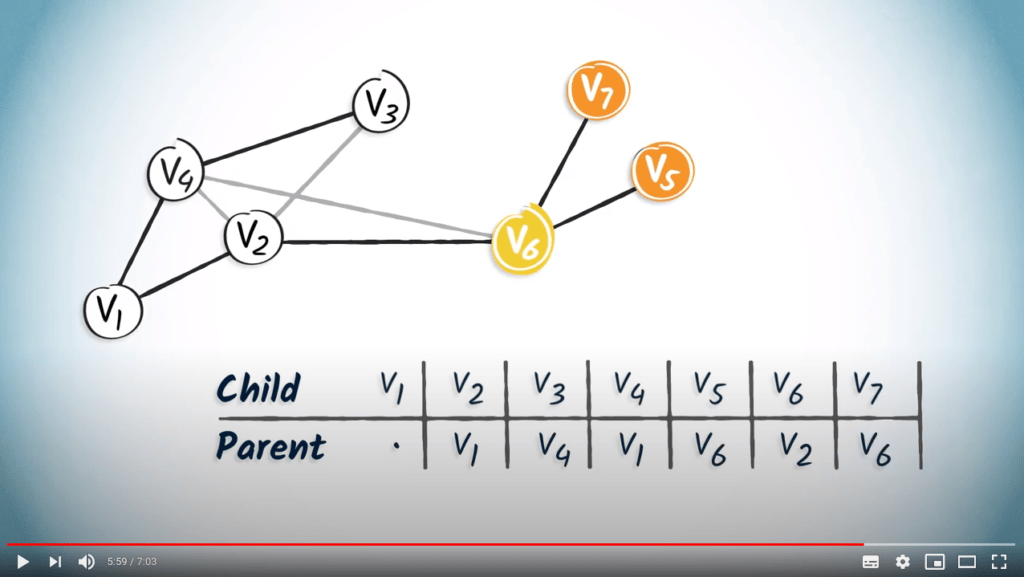
Ensuite, $v_6$ a deux enfants, $v_7$ et $v_5$. La table de routage est complète.
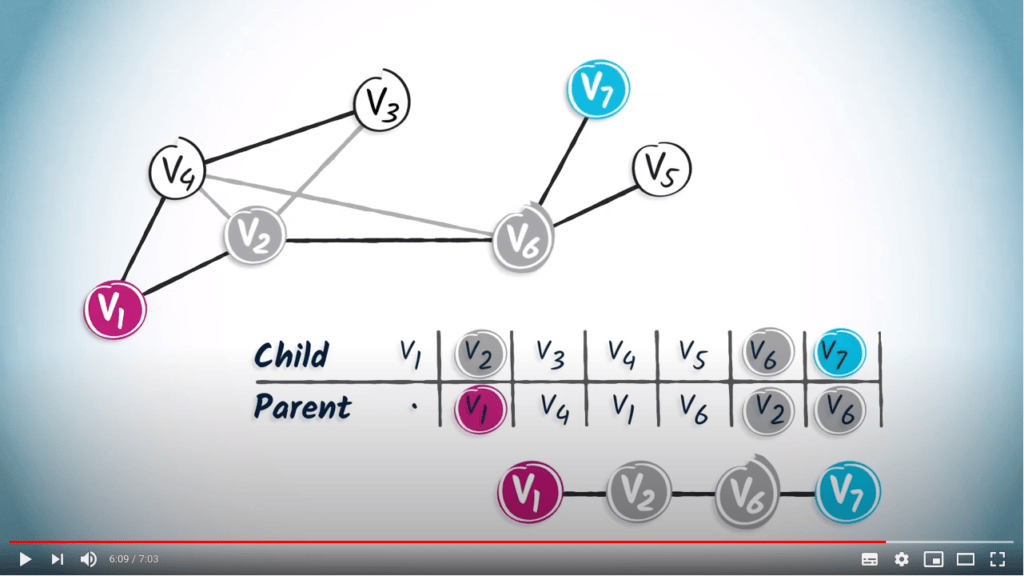
Si nous lisons le chemin de $v_1$ à $v_7$ dans la table, nous obtenons $(v_7, v_6, v_2, v_1)$.
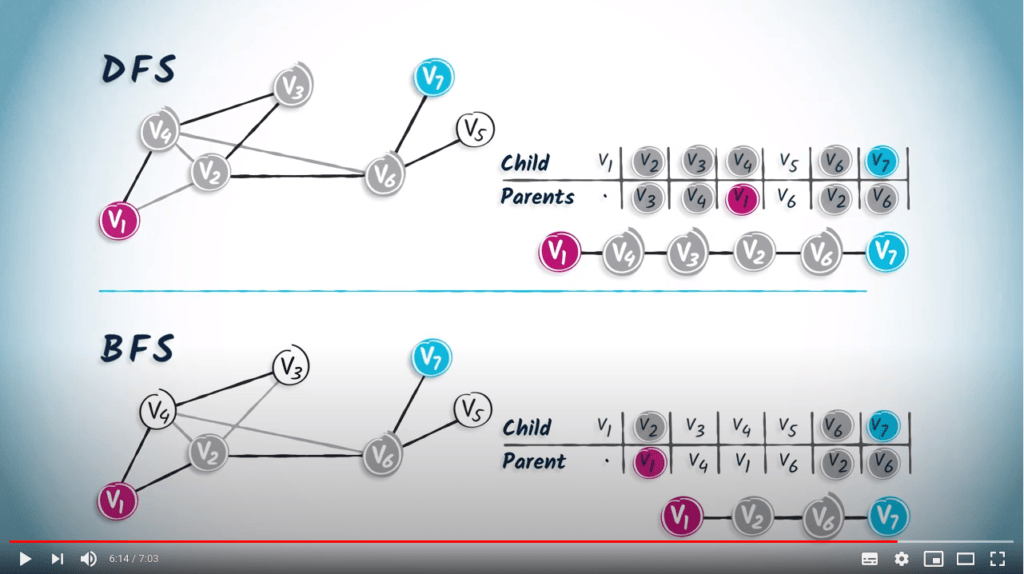
Nous pouvons voir que ce chemin est plus court que celui obtenu en utilisant un DFS, qui était $(v_7, v_6, v_2, v_3, v_4, v_1)$. C’est une différence importante entre DFS et BFS. BFS est une approche plus prudente que DFS, car BFS augmente progressivement la distance depuis la position de départ.
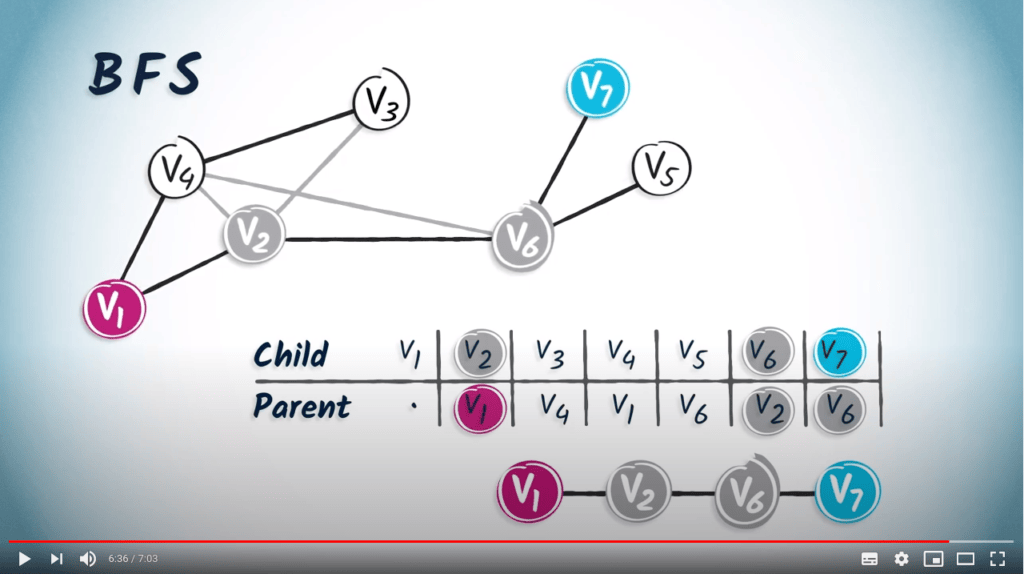
En utilisant BFS, nous pouvons être absolument certains de trouver le chemin le plus court entre deux sommets.
C’est tout pour aujourd’hui. Merci pour votre attention ! J’ai vraiment apprécié parler de routage avec vous.
Vous devez vous rappeler qu’il ne suffit pas de construire l’arbre couvrant pour naviguer entre les sommets du graphe, mais qu’il vous faut également un algorithme de routage.
À bientôt pour de nouvelles aventures algorithmiques !
Implémentation des tables de routage
Pour implémenter des tables de routage dans un langage de programmation, vous avez besoin d’une structure de données qui peut vous aider à associer les sommets à leurs parents le long du parcours. Dans l’article sur comment représenter les graphes en mémoire, vous avez étudié quelques-unes de ces structures. Avec un peu d’imagination, toutes ces structures peuvent être utilisées pour implémenter des tables de routage. Voici quelques pistes :
-
Tableaux ou listes – Numérotez arbitrairement les sommets du graphe de 1 à $n$. Utilisez un tableau de taille $n$, ou une liste initialisée avec $n$ entrées égales à 0 (ou toute valeur en dehors de l’intervalle $[1, n]$). Ensuite, pour indiquer que le sommet à l’index $i$ est un prédécesseur du sommet à l’index $j$, il suffit de placer $i$ dans l’entrée $j$ de la structure. Plus tard, pour récupérer le chemin, il sera nécessaire de convertir les indices en sommets réels pour obtenir le chemin.
-
Dictionnaires – L’utilisation de dictionnaires est un peu plus directe, car ce sont des structures qui peuvent directement associer des variables à d’autres. Ainsi, il n’est pas nécessaire de numéroter les sommets. Par conséquent, pour indiquer que $v_1$ est un prédécesseur de $v_2$, il suffit d’associer la valeur $v_1$ à la clé $v_2$ dans la structure.
Pour aller plus loin
Pourquoi stocker les parents plutôt que les enfants ?
Dans un arbre enraciné, chaque sommet autre que la racine a exactement un parent, mais il peut avoir plusieurs enfants, ou aucun. Stocker le parent de chaque sommet donne donc une structure très simple, avec une seule valeur par sommet.
Stocker les enfants demanderait au contraire une liste par sommet. Surtout, pour aller de la racine à une destination, il faudrait choisir à chaque sommet dans quelle branche descendre, sans savoir laquelle mène à la destination. En partant de la destination et en remontant vers la racine, il n’y a qu’un seul choix possible à chaque étape : le parent. C’est pour cette raison que le routage se lit à l’envers, comme expliqué dans la vidéo.
Une seule table pour tous les chemins
Une table de routage obtenue par un BFS contient un plus court chemin depuis le sommet de départ vers chaque sommet atteignable, et elle n’utilise pour cela qu’une entrée par sommet.
À titre de comparaison, imaginons que l’on stocke explicitement chacun de ces chemins, sous forme de liste de sommets. Dans un labyrinthe en forme de long couloir de $n$ cases, parcouru depuis l’une de ses extrémités, les chemins contiennent respectivement $1, 2, \dots, n$ sommets. Il faudrait donc stocker $\frac{n(n+1)}{2}$ sommets au total, soit une mémoire en $O(n^2)$, contre $O(n)$ pour la table de routage.
Cette économie est possible car les chemins partagent leurs débuts. Si $(u, \dots, w, v)$ est un plus court chemin de $u$ à $v$, alors $(u, \dots, w)$ est un plus court chemin de $u$ à $w$. En effet, s’il existait un chemin plus court de $u$ à $w$, il suffirait de lui ajouter l’arête $\{w,v\}$ pour obtenir un chemin plus court de $u$ à $v$. Il suffit donc de retenir, pour chaque sommet, par où l’on y arrive : c’est exactement ce que fait la table de routage.
Deux remarques pratiques en découlent :
- Retrouver un chemin de $k$ arêtes demande $k$ lectures dans la table. Avec un dictionnaire, chaque lecture se fait en temps constant, donc le coût est proportionnel à la longueur du chemin, et non à la taille du graphe.
- Un sommet apparaît comme clé dans la table si et seulement si il est atteignable depuis le sommet de départ, puisque le parcours explore exactement les sommets atteignables (voir l’article sur les parcours). La table permet donc aussi de savoir immédiatement si une destination peut être atteinte.
Partir de la destination
Dans un graphe non orienté, un chemin de $t$ à $v$ lu à l’envers est un chemin de $v$ à $t$. On peut donc effectuer le parcours depuis la destination $t$ plutôt que depuis le point de départ. Dans la table obtenue, le parent d’un sommet $v$ est alors le prochain sommet où aller pour se rapprocher de $t$. Avec un BFS, suivre ces parents depuis n’importe quel sommet donne un plus court chemin jusqu’à $t$.
Ce point de vue est intéressant lorsque la destination est fixe, mais que le point de départ ne l’est pas. Par exemple, dans PyRat, on peut effectuer un parcours depuis le morceau de fromage au début de la partie. À chaque tour, il suffit ensuite de lire dans la table le parent de la case où se trouve le rat, sans avoir besoin de reconstruire un chemin complet :
C’est aussi ainsi que fonctionnent les routeurs d’Internet. Chaque routeur possède une table qui associe, à chaque destination possible, le routeur voisin auquel transmettre les données pour s’en rapprocher. Autrement dit, l’entrée correspondant à une destination $t$ dans le routeur $v$ est le parent de $v$ dans un arbre de plus courts chemins enraciné en $t$. Ces tables ne sont pas calculées par un parcours centralisé, mais par des protocoles où les routeurs échangent progressivement des informations avec leurs voisins.
Information
Dans un graphe orienté, cette astuce ne fonctionne plus directement, car un chemin de $t$ à $v$ lu à l’envers n’est pas forcément un chemin de $v$ à $t$. Il faut alors effectuer le parcours depuis $t$ en suivant les arêtes dans le sens inverse.
Pour aller encore plus loin
-
Les tables de routage utilisées par les routeurs des réseaux informatiques, qui indiquent où transmettre les données pour atteindre chaque destination.
-
Un protocole historique d’Internet, dans lequel les routeurs construisent leurs tables de routage en échangeant des distances avec leurs voisins.
-
Une autre structure de données où chaque élément stocke simplement son parent dans un arbre, utilisée par exemple pour savoir rapidement si deux sommets sont dans la même composante connexe.