Voici quelques exercices pour vous faire manipuler des programmes simples et votre IDE.
Pendant cette activité, veuillez porter attention aux bonnes pratiques de programmation que vous avez étudiées précédemment. Ce sont de bons réflexes à acquérir rapidement.
Pour chaque exercice, nous vous demandons de montrer votre solution à un(e) autre étudiant(e), afin qu’il/elle puisse vous faire des remarques sur la lisibilité.
Important
Le but de cette séance est de vous aider à maîtriser des notions importantes en informatique. Un assistant de programmation intelligent tel que GitHub Copilot sera capable de vous fournir une solution à ces exercices uniquement à partir d’un nom de fichier judicieusement choisi.
Pour comprendre et apprendre, vous ne devez pas utiliser ces outils pour l’instant.
Prendre le temps de réfléchir, de concevoir des algorithmes et de les coder vous-même est essentiel pour acquérir les compétences nécessaires.
Contenu de l’activité
Correction de bugs syntaxiques
Le code suivant contient une erreur de syntaxe. Utilisez l’onglet Erreur de votre IDE pour trouver l’emplacement de l’erreur. Que dit-il ?
# The string to manipulates ="IMT Atlantique"print(s)
# Loop to append to a new stringresult =""for i j in range(len(s)):
result = s[i] + result
# Print the resultprint("Reversed string:", result)
À faire
Essayez de corriger l’erreur et exécutez à nouveau le code pour voir la différence !
Correction
Cliquez ici pour afficher la correction.
# The string to manipulates ="IMT Atlantique"print(s)
# Loop to append to a new stringresult =""for i j in range(len(s)):
result = s[i] + result
# Print the resultprint("Reversed string:", result)
Sortie
Expected "in" Pylance [Ln 7, Col 7]
Unexpected indentation Pylance [Ln 8, Col 1]
Unindent not expected Pylance [Ln 11, Col 1]
Comme vous pouvez le voir, l’onglet Problèmes ne vous dit pas directement qu’il y a un j en trop. Comme il essaie d’analyser le programme, il rencontre quelque chose d’inattendu, et vous l’indique. Dans ce cas, les erreurs affichées sont des conséquences indirectes de votre erreur de syntaxe.
Par conséquent, vous devrez parfois interpréter les messages pour relier les messages d’erreur aux erreurs réelles à corriger. Avec le temps et l’expérience, vous apprendrez à interpréter ces messages efficacement.
Vérifiez à nouveau votre code. Votre IDE devrait avoir souligné les lignes correspondant aux problèmes identifiés ci-dessus. Cela vous aidera à trouver les erreurs plus facilement.
Essayez de corriger l’erreur et exécutez à nouveau le code pour voir la différence !
# The string to manipulates ="IMT Atlantique"print(s)
# Loop to append to a new stringresult =""for i in range(len(s)):
result = s[i] + result
# Print the resultprint("Reversed string:", result)
Correction de bugs sémantiques
Voici un code qui est syntaxiquement correct :
# Needed importsimport random
# Fill a list with 10 random numbersnumbers = []
for i in range(10):
numbers.append(random.randint(-50, 50))
# Let's do the following operation 50 timesfor i in range(50):
# Divide each number by the subtraction of the two next numbers in the listfor j in range(len(numbers) -2):
numbers[j] /= numbers[j +1] - numbers[j +2]
# Print the final listprint("Final list", numbers)
Cependant, lors de son exécution, on obtient la sortie suivante :
Sortie
Traceback (most recent call last):
  File "session_1.py", line 14, in <module>
    numbers[j] /= numbers[j + 1] - numbers[j + 2]
ZeroDivisionError: float division by zero
À faire
Utilisez la commande print pour trouver la source de l’erreur. C’est-à-dire, ajoutez quelques print là où c’est pertinent pour comprendre ce qui mène à l’erreur. Puis exécutez le code et essayez d’analyser pourquoi cela arrive.
Correction
Cliquez ici pour afficher la correction.
# Needed importsimport random
# Fill a list with 10 random numbersnumbers = []
for i in range(10):
numbers.append(random.randint(-50, 50))
# Let's do the following operation 50 timesfor i in range(50):
# Divide each number by the subtraction of the two next numbers in the listfor j in range(len(numbers) -2):
numbers[j] /= numbers[j +1] - numbers[j +2]
# Print the final listprint("Final list", numbers)
Cependant, lors de son exécution, on obtient la sortie suivante :
Sortie
Traceback (most recent call last):
  File "session_1.py", line 14, in <module>
    numbers[j] /= numbers[j + 1] - numbers[j + 2]
ZeroDivisionError: float division by zero
Utilisez la commande print pour trouver la source de l’erreur. C’est-à-dire, ajoutez quelques print là où c’est pertinent pour comprendre ce qui mène à l’erreur. Puis exécutez le code et essayez d’analyser pourquoi cela arrive.
Avant toute chose, notez que le programme utilise des nombres aléatoires. Par conséquent, nous devrions fixer la graine à une valeur qui mène à l’erreur. Sur notre ordinateur, la graine 42 mène à une erreur. Cela peut être différent pour vous, essayez de trouver une telle valeur.
# Needed importsimport random
# Set the seedrandom.seed(42)
# Fill a list with 10 random numbersnumbers = []
for i in range(10):
numbers.append(random.randint(-50, 50))
# Let's do the following operation 50 timesfor i in range(50):
# Divide each number by the subtraction of the two next numbers in the listfor j in range(len(numbers) -2):
numbers[j] /= numbers[j +1] - numbers[j +2]
# Print the final listprint("Final list", numbers)
À ce stade, on obtient la sortie suivante lors de l’exécution du programme :
Sortie
Traceback (most recent call last):
  File "session_1.py", line 17, in <module>
    numbers[j] /= numbers[j + 1] - numbers[j + 2]
ZeroDivisionError: float division by zero
Le message d’erreur nous indique que le crash se produit dans la dernière boucle. Cela semble lié à la soustraction de deux nombres qui vaut 0. Regardons la liste numbers avant cette boucle, et quelles parties posent problème.
# Needed importsimport random
# Set the seedrandom.seed(42)
# Fill a list with 10 random numbersnumbers = []
for i in range(10):
numbers.append(random.randint(-50, 50))
# Let's do the following operation 50 timesfor i in range(50):
# Debug print("Current list", numbers)
# Divide each number by the subtraction of the two next numbers in the listfor j in range(len(numbers) -2):
# Debug print(" numbers[j+1] =", numbers[j +1], "/ numbers[j+2] =", numbers[j +2], "/ difference =", numbers[j +1] - numbers[j +2])
numbers[j] /= numbers[j +1] - numbers[j +2]
# Print the final listprint("Final list", numbers)
L’erreur vient d’une soustraction -0.0 - (-0.0) = 0.0, qui met le dénominateur de la division à 0.
L’apparition de ces 0 est causée par une très rapide diminution de toutes les valeurs dans la liste (sauf les deux dernières).
Nous avons trouvé la source de notre problème ! La correction dépend évidemment de ce que l’algorithme était censé faire, car c’est un exemple didactique.
Notez toutefois que l’erreur n’est pas causée par la présence de deux nombres aléatoires consécutifs dans la liste initiale, ce qui aurait pu être la solution la plus simple à laquelle vous auriez pensé ! Comme les erreurs ne sont pas toujours évidentes, exécutez toujours fréquemment vos programmes et utilisez des outils de débogage !
Maintenant, utilisez le débogueur pas à pas de VSCode pour déboguer le même programme. Comment faire ?
Comme l’erreur se produit à la ligne 14, mettons un point d’arrêt à cette ligne. Puis, en exécutant le débogueur pas à pas, observons le contenu des variables à chaque fois que ce point d’arrêt est atteint :
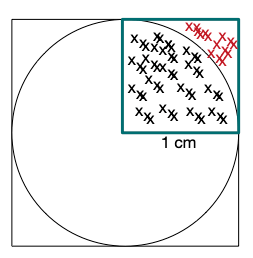
Vous allez implémenter une stratégie de Monte Carlo pour estimer la valeur de $\pi$. Le principe illustré dans la figure ci-dessous est de générer pseudo-aléatoirement les coordonnées cartésiennes de points situés dans le sous-espace unité, le carré cyan foncé. Considérant $n$ points pseudo-aléatoires générés, le rapport entre le nombre de points situés dans le quart supérieur droit du disque et le nombre total de points générés est une estimation de $\frac{\pi}{4}$.
Pour déterminer si un point est dans le quart supérieur droit du disque, il suffit de calculer sa distance euclidienne à l’origine. Si cette distance est inférieure à 1, il est dans le disque. Pour rappel, pour un point dont les coordonnées sont $(x,y)$, la distance à l’origine se calcule comme suit : $\sqrt{x^2 + y^2}$.
Récupérez vos outils
Pour estimer $\pi$, vous avez besoin de quelques outils de programmation :
Un générateur de nombres aléatoires, et une méthode de ce générateur pour obtenir un nombre dans l’intervalle $[0, 1]$.
Trouvez la méthode correcte dans la documentation du module random.
Une méthode pour calculer la racine carrée d’une valeur.
Trouvez la méthode correcte dans la documentation du module math.
Vous demanderez via une invite le nombre de points à générer (la valeur à affecter à $n$). Pour ce faire, utilisez la fonction intégrée input.
À faire
Suivons quelques étapes pour obtenir un programme fonctionnel.
Correction
Cliquez ici pour afficher la correction.
Une méthode pour calculer la racine carrée d’une valeur.
Trouvez la méthode correcte dans la documentation du module math.
Vous demanderez via une invite le nombre de points à générer (la valeur à affecter à $n$). Pour ce faire, utilisez la fonction intégrée input.
Suivons quelques étapes pour obtenir un programme fonctionnel.
Découpez votre algorithme en morceaux
Un code source complet est toujours écrit pas à pas, et chaque étape testée. C’est clairement la meilleure et la seule façon d’atteindre efficacement l’objectif. Alors, selon vous, que devons-nous faire ?
---
secondary_color: lightgray
---
# Quiz
Mettez les étapes proposées dans l'ordre !
1. Demander la valeur de $n$.
2. Définir une boucle qui fera $n$ tours.
3. Générer des points aléatoires dans le sous-espace unité.
4. Calculer la distance entre un point pseudo-aléatoire et l'origine.
5. Estimer la valeur de $\pi$.
Implémentez cet algorithme étape par étape, et utilisez l’instruction print pour vérifier que chaque étape semble correcte.
En faisant varier la valeur de $n$, observez la précision de l’estimation de $\pi$ obtenue.
Correction
Cliquez ici pour révéler la réponse.
Voici quelques résultats possibles que nous avons observés. Notez que, comme nous utilisons des nombres aléatoires, vous pouvez obtenir des résultats différents.
N
Estimation de pi
10
3.6
100
3.12
1 000
3.128
10 000
3.126
100 000
3.13728
1 000 000
3.140592
10 000 000
3.1423096
100 000 000
3.14147488
À faire
Complétez le tableau ci-dessus.
Correction
Cliquez ici pour afficher la correction.
Écrivons le programme étape par étape. D’abord, demandons une valeur de $n$ et vérifions que l’entrée fonctionne comme prévu. Nous ajoutons aussi directement les imports et la graine aléatoire. Le print nous aide à vérifier que l’entrée fonctionne bien, et que notre conversion de type est correcte.
# Number of points to generaten = int(input("Enter the number of points to generate: "))
print(n, type(n))
Maintenant, générons $n$ points. Ici, nous choisissons de fixer la graine aléatoire pour faciliter le débogage au cas où nous en aurions besoin.
# Needed importsimport random
# Set the seedrandom.seed(42)
# Number of points to generaten = int(input("Enter the number of points to generate: "))
# Generate the pointsfor i in range(n):
x = random.random()
y = random.random()
print("(%f, %f)"% (x, y))
Tout semble correct, continuons. Pour estimer $\pi$, déterminez le nombre de points qui tombent dans le cercle unité (calcul de la norme de l’origine au point).
# Needed importsimport random
from math import sqrt
# Set the seedrandom.seed(42)
# Number of points to generaten = int(input("Enter the number of points to generate: "))
# Number of points inside the circle (initially 0)nb_pt_inside =0for i in range(n):
# Generate the point x = random.random()
y = random.random()
# Check if the point is inside the circleif sqrt(x**2+ y**2) <=1:
nb_pt_inside +=1# Estimate piestimate_pi =4* nb_pt_inside / n
print("Estimate of pi: ", estimate_pi)
En faisant varier la valeur de $n$, observez la précision de l’estimation de $\pi$ obtenue.
Voici quelques résultats possibles que nous avons observés. Notez que, comme nous utilisons des nombres aléatoires, vous pouvez obtenir des résultats différents.
N
Estimation de pi
10
3.6
100
3.12
1 000
3.128
10 000
3.126
100 000
3.13728
1 000 000
3.140592
10 000 000
3.1423096
100 000 000
3.14147488
Un problème classique de tri
Trier un tableau (ou une liste) de valeurs selon une relation d’ordre est un problème algorithmique très classique. Il est souvent utilisé pour découvrir empiriquement des concepts théoriques tels que la terminaison, la complexité, etc.
Deux variantes de la stratégie de tri par sélection
L’algorithme de tri par sélection est très facile à comprendre (voici une explication avec musique et gestes). Considérez que vous avez un jeu de cartes non triées dans votre main droite et que vous construisez progressivement une permutation triée de ces cartes dans votre main gauche. La stratégie du tri par sélection consiste d’abord à sélectionner la carte ayant la plus petite valeur dans votre main droite et à la placer en première position dans votre main gauche. Vous faites ensuite de même avec la carte ayant la deuxième plus petite valeur, et ainsi de suite.
Identifiez les différentes étapes pour finalement avoir un programme qui génère un tableau de taille N (une constante choisie) composé de valeurs générées aléatoirement, puis trie ce tableau par sélection et vérifie que le tableau est bien trié. Puis écrivez un programme qui effectue ce tri.
Une fois le programme prêt, écrivez une étape supplémentaire pour vérifier que le tableau est bien trié. Testez sa correction en essayant différentes valeurs pour N (impaires et paires). De plus, assurez-vous que le programme gère plusieurs occurrences des mêmes valeurs dans le tableau.
À faire
Une légère variation de l’algorithme consiste à positionner la plus petite et la plus grande valeur en même temps, la deuxième plus petite et la deuxième plus grande, etc. Implémentez cette stratégie dans un nouveau script.
Correction
Cliquez ici pour afficher la correction.
# Needed importsimport random
import time
# ConstantsN =10# Set the seedrandom.seed(42)
# Generate a random list of N numberslist_to_sort = [random.randint(0, 100) for i in range(N)]
print("Unsorted list:", list_to_sort)
# Get the current time# We are going to measure execution time for info# Here, we measure the process time rather than the elapsed timestart = time.process_time()
# Iterate over each cell of the listfor i in range(N-1):
# Find the smallest value in the remaining part of the list (i.e., from i to N-1)# Below, we provide an implementation based on loops# It is equivalent to the following code:# index_min = numpy.argmin(list_to_sort[:i]) index_min = i
for j in range(i+1, N):
if list_to_sort[j] < list_to_sort[index_min]:
index_min = j
# Exchange value at position i with the smallest value found list_to_sort[i], list_to_sort[index_min] = list_to_sort[index_min], list_to_sort[i]
# Get the current time after sorting# The difference will give us the execution timestop = time.process_time()
print("Sorted list in %f seconds"% (stop - start))
# Check that the list is indeed sortedi =1while i < N and list_to_sort[i] >= list_to_sort[i-1]:
i +=1print("Is the list sorted?", i == N)
print("Sorted list:", list_to_sort)
Une légère variation de l’algorithme consiste à positionner la plus petite et la plus grande valeur en même temps, la deuxième plus petite et la deuxième plus grande, etc. Implémentez cette stratégie dans un nouveau script.
# Needed importsimport random
import time
# ConstantsN =10# Set the seedrandom.seed(42)
# Generate a random list of N numberslist_to_sort = [random.randint(0, 100) for i in range(N)]
print("Unsorted list:", list_to_sort)
# Get the current time# We are going to measure execution time for info# Here, we measure the process time rather than the elapsed timestart = time.process_time()
# Iterate over each cell of the listfor i in range((N-1) //2+1):
# Find the smallest and the highest value in the remaining part of the list (i.e., from i to N-1)# Below, we provide an implementation based on loops# It is equivalent to the following code:# index_min = numpy.argmin(list_to_sort[:i])# index_max = numpy.argmax(list_to_sort[:i]) index_min = i
index_max = i
for j in range(i+1, N-i):
if list_to_sort[j] < list_to_sort[index_min]:
index_min = j
if list_to_sort[j] > list_to_sort[index_max]:
index_max = j
# Exchange value at position i with the smallest value found list_to_sort[i], list_to_sort[index_min] = list_to_sort[index_min], list_to_sort[i]
# In case the highest value is located at position i and would be erased by the lowest value foundif index_max == i:
index_max = index_min
# Exchange value at position N-i-1 with the highest value found list_to_sort[N-i-1], list_to_sort[index_max] = list_to_sort[index_max], list_to_sort[N-i-1]
# Get the current time after sorting# The difference will give us the execution timestop = time.process_time()
print("Sorted list in %f seconds"% (stop - start))
# Check that the list is indeed sortedi =1while i < N and list_to_sort[i] >= list_to_sort[i-1]:
i +=1print("Is the list sorted?", i == N)
print("Sorted list:", list_to_sort)
Comparaison empirique de leur efficacité
Pour chacune des stratégies de tri que vous avez développées dans la section précédente, assurez-vous de créer un script dédié. Dans la suite, nous supposons que le premier s’appelle selection_sort_min.py, et le second selection_sort_min_max.py.
Puis, adaptez les deux scripts comme suit :
Le seul print qu’ils doivent faire est le temps écoulé pour trier la liste, c’est-à-direprint(stop - start) dans les corrections ci-dessus (sans aucun autre texte).
Supprimez tous les autres prints, ainsi que le test final pour vérifier si la liste est triée.
Adaptez votre script pour récupérer la valeur de N depuis le premier argument en ligne de commande, c’est-à-dire en utilisant sys.argv[1].
N’oubliez pas de la convertir en entier.
Adaptez votre script pour récupérer la valeur de la graine aléatoire depuis le second argument en ligne de commande, c’est-à-dire en utilisant sys.argv[2].
N’oubliez pas de la convertir en entier.
Maintenant, créez un nouveau script Python qui utilise la fonction intégrée sorted de Python. Ci-dessous, nous supposons que ce script s’appelle built_in_sorted.py. Il doit respecter les mêmes adaptations que les deux autres scripts ci-dessus, c’est-à-dire,
Être exécutable depuis la ligne de commande avec la commande suivante :
python <script_name> <N> <seed>
python <script_name> <N> <seed>
python3 <script_name> <N> <seed>
python3 <script_name> <N> <seed>
Afficher le temps total écoulé en résultat.
Cette fonction utilise un algorithme plus avancé appelé Powersort. De plus, lors de l’appel à sorted, l’interpréteur appelle une version compilée de la fonction de tri en arrière-plan. Elle peut donc être directement interprétée en code binaire par votre ordinateur, et est donc beaucoup plus rapide.
Important
La plupart des fonctions intégrées de Python (et celles des bibliothèques) utilisent la même astuce, il est donc toujours préférable de les utiliser plutôt que de réinventer la roue. Moins vous écrivez de boucles, plus votre code Python sera rapide !
Maintenant, placez le script suivant dans le même répertoire que les fichiers que vous venez de créer. N’oubliez pas d’adapter les noms de fichiers. Ce script exécutera tous les autres scripts pour différentes tailles d’entrée, et créera un fichier .csv avec les temps moyens. Il utilisera également la graine aléatoire pour s’assurer que tous les scripts sont comparés dans les mêmes conditions.
# Needed importsimport subprocess
import os
# ConstantsSCRIPTS = ['selection_sort_min.py', 'selection_sort_min_max.py', 'built_in_sorted.py']
NB_TESTS_FOR_AVERAGE =10VALUES_OF_N = [10, 100, 1000, 10000]
OUTPUT_FILE_NAME ='average_execution_times.csv'PYTHON_EXECUTABLE ="python"# We will write the average execution time for each script in a filecurrent_dir = os.path.dirname(__file__)
output_file = open(os.path.join(current_dir, OUTPUT_FILE_NAME), 'w', buffering=1)
# Loop over each scriptfor script in SCRIPTS:
# Loop over each value of N results_for_n = []
for n in VALUES_OF_N:
# Loop over each test execution_times = []
for seed in range(NB_TESTS_FOR_AVERAGE):
# Run the script command = [PYTHON_EXECUTABLE, os.path.join(current_dir, script), str(n), str(seed)]
output = subprocess.run(command, capture_output=True, text=True)
result = float(output.stdout)
execution_times.append(result)
# Compute the average execution time average_execution_time = sum(execution_times) / NB_TESTS_FOR_AVERAGE
results_for_n.append(average_execution_time)
# Write the results for the current script output_file.write(script +';')
output_file.write(';'.join([str(result) for result in results_for_n]))
output_file.write('\n')
# Close the fileoutput_file.close()
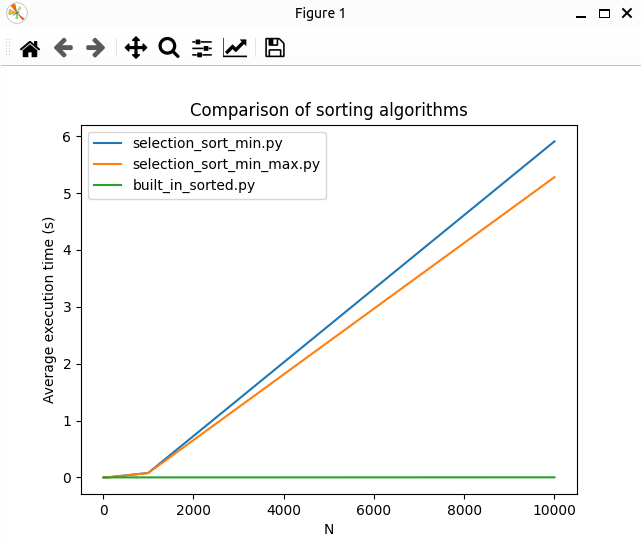
Puis, utilisez soit LibreOffice, Microsoft Office, ou tout logiciel équivalent, pour tracer, pour chaque script, le temps moyen en fonction de la taille de la liste. Alternativement, vous pouvez aussi installer le paquet Python matplotlib pour créer cette courbe. Voici un script pour le faire.
# Needed importsimport os
import matplotlib.pyplot as plt
# ConstantsVALUES_OF_N = [10, 100, 1000, 10000]
CSV_FILE_NAME ='average_execution_times.csv'# Read the results from the filecurrent_dir = os.path.dirname(__file__)
results = {}
with open(os.path.join(current_dir, CSV_FILE_NAME), 'r') as file:
for line in file:
split_line = line.strip().split(';')
script = split_line[0]
times = [float(time) for time in split_line[1:]]
results[script] = times
# Plot the resultsfig, ax = plt.subplots()
for script, times in results.items():
ax.plot(VALUES_OF_N, times, label=script)
ax.set_xscale("log")
ax.set_yscale("log")
ax.set_xlabel("N")
ax.set_ylabel("Average execution time (s)")
ax.set_title("Comparison of sorting algorithms")
ax.legend()
plt.show()
Correction
Cliquez ici pour révéler la réponse.
À faire
Répondez à la question ci-dessus.
Correction
Cliquez ici pour afficher la correction.
Adaptez votre script pour récupérer la valeur de N depuis le premier argument en ligne de commande, c’est-à-dire en utilisant sys.argv[1].
N’oubliez pas de la convertir en entier.
Adaptez votre script pour récupérer la valeur de la graine aléatoire depuis le second argument en ligne de commande, c’est-à-dire en utilisant sys.argv[2].
N’oubliez pas de la convertir en entier.
# Needed importsimport random
import time
import sys
# ConstantsN = int(sys.argv[1])
# Set the seedrandom.seed(int(sys.argv[2]))
# Generate a random list of N numberslist_to_sort = [random.randint(0, 100) for i in range(N)]
# Get the current time# We are going to measure execution time for info# Here, we measure the process time rather than the elapsed timestart = time.process_time()
# Iterate over each cell of the listfor i in range(N-1):
# Find the smallest value in the remaining part of the list (i.e., from i to N-1)# Below, we provide an implementation based on loops# It is equivalent to the following code:# index_min = numpy.argmin(list_to_sort[:i]) index_min = i
for j in range(i+1, N):
if list_to_sort[j] < list_to_sort[index_min]:
index_min = j
# Exchange value at position i with the smallest value found list_to_sort[i], list_to_sort[index_min] = list_to_sort[index_min], list_to_sort[i]
# Get the current time after sorting# The difference will give us the execution timestop = time.process_time()
print(stop - start)
# Needed importsimport random
import time
import sys
# ConstantsN = int(sys.argv[1])
# Set the seedrandom.seed(int(sys.argv[2]))
# Generate a random list of N numberslist_to_sort = [random.randint(0, 100) for i in range(N)]
# Get the current time# We are going to measure execution time for info# Here, we measure the process time rather than the elapsed timestart = time.process_time()
# Iterate over each cell of the listfor i in range((N-1) //2+1):
# Find the smallest and the highest value in the remaining part of the list (i.e., from i to N-1)# Below, we provide an implementation based on loops# It is equivalent to the following code:# index_min = numpy.argmin(list_to_sort[:i])# index_max = numpy.argmax(list_to_sort[:i]) index_min = i
index_max = i
for j in range(i+1, N-i):
if list_to_sort[j] < list_to_sort[index_min]:
index_min = j
if list_to_sort[j] > list_to_sort[index_max]:
index_max = j
# Exchange value at position i with the smallest value found list_to_sort[i], list_to_sort[index_min] = list_to_sort[index_min], list_to_sort[i]
# In case the highest value is located at position i and would be erased by the lowest value foundif index_max == i:
index_max = index_min
# Exchange value at position N-i-1 with the highest value found list_to_sort[N-i-1], list_to_sort[index_max] = list_to_sort[index_max], list_to_sort[N-i-1]
# Get the current time after sorting# The difference will give us the execution timestop = time.process_time()
print(stop - start)
Maintenant, créez un nouveau script Python qui utilise la fonction intégrée sorted de Python. Ci-dessous, nous supposons que ce script s’appelle built_in_sorted.py. Il doit respecter les mêmes adaptations que les deux autres scripts ci-dessus, c’est-à-dire,
Être exécutable depuis la ligne de commande avec la commande suivante :
python <script_name> <N> <seed>
python <script_name> <N> <seed>
python3 <script_name> <N> <seed>
python3 <script_name> <N> <seed>
Afficher le temps total écoulé en résultat.
# Needed importsimport random
import time
import sys
# ConstantsN = int(sys.argv[1])
# Set the seedrandom.seed(int(sys.argv[2]))
# Generate a random list of N numberslist_to_sort = [random.randint(0, 100) for i in range(N)]
# Get the current time# We are going to measure execution time for info# Here, we measure the process time rather than the elapsed timestart = time.process_time()
# Sort the listlist_to_sort = sorted(list_to_sort)
# Get the current time after sorting# The difference will give us the execution timestop = time.process_time()
print(stop - start)
Cette fonction utilise un algorithme plus avancé appelé Powersort. De plus, lors de l’appel à sorted, l’interpréteur appelle une version compilée de la fonction de tri en arrière-plan. Elle peut donc être directement interprétée en code binaire par votre ordinateur, et est donc beaucoup plus rapide.
Important
La plupart des fonctions intégrées de Python (et celles des bibliothèques) utilisent la même astuce, il est donc toujours préférable de les utiliser plutôt que de réinventer la roue. Moins vous écrivez de boucles, plus votre code Python sera rapide !
Maintenant, placez le script suivant dans le même répertoire que les fichiers que vous venez de créer. N’oubliez pas d’adapter les noms de fichiers. Ce script exécutera tous les autres scripts pour différentes tailles d’entrée, et créera un fichier .csv avec les temps moyens. Il utilisera également la graine aléatoire pour s’assurer que tous les scripts sont comparés dans les mêmes conditions.
# Needed importsimport subprocess
import os
# ConstantsSCRIPTS = ['selection_sort_min.py', 'selection_sort_min_max.py', 'built_in_sorted.py']
NB_TESTS_FOR_AVERAGE =10VALUES_OF_N = [10, 100, 1000, 10000]
OUTPUT_FILE_NAME ='average_execution_times.csv'PYTHON_EXECUTABLE ="python"# We will write the average execution time for each script in a filecurrent_dir = os.path.dirname(__file__)
output_file = open(os.path.join(current_dir, OUTPUT_FILE_NAME), 'w', buffering=1)
# Loop over each scriptfor script in SCRIPTS:
# Loop over each value of N results_for_n = []
for n in VALUES_OF_N:
# Loop over each test execution_times = []
for seed in range(NB_TESTS_FOR_AVERAGE):
# Run the script command = [PYTHON_EXECUTABLE, os.path.join(current_dir, script), str(n), str(seed)]
output = subprocess.run(command, capture_output=True, text=True)
result = float(output.stdout)
execution_times.append(result)
# Compute the average execution time average_execution_time = sum(execution_times) / NB_TESTS_FOR_AVERAGE
results_for_n.append(average_execution_time)
# Write the results for the current script output_file.write(script +';')
output_file.write(';'.join([str(result) for result in results_for_n]))
output_file.write('\n')
# Close the fileoutput_file.close()
Puis, utilisez soit LibreOffice, Microsoft Office, ou tout logiciel équivalent, pour tracer, pour chaque script, le temps moyen en fonction de la taille de la liste. Alternativement, vous pouvez aussi installer le paquet Python matplotlib pour créer cette courbe. Voici un script pour le faire.
# Needed importsimport os
import matplotlib.pyplot as plt
# ConstantsVALUES_OF_N = [10, 100, 1000, 10000]
CSV_FILE_NAME ='average_execution_times.csv'# Read the results from the filecurrent_dir = os.path.dirname(__file__)
results = {}
with open(os.path.join(current_dir, CSV_FILE_NAME), 'r') as file:
for line in file:
split_line = line.strip().split(';')
script = split_line[0]
times = [float(time) for time in split_line[1:]]
results[script] = times
# Plot the resultsfig, ax = plt.subplots()
for script, times in results.items():
ax.plot(VALUES_OF_N, times, label=script)
ax.set_xscale("log")
ax.set_yscale("log")
ax.set_xlabel("N")
ax.set_ylabel("Average execution time (s)")
ax.set_title("Comparison of sorting algorithms")
ax.legend()
plt.show()
Pour aller plus loin
Un problème classique de tri (encore)
Concevez un algorithme basé sur des comparaisons de tri qui satisfait l’invariant suivant :
Après i itérations de la boucle interne, les i plus grandes valeurs de la liste l de taille N sont triées dans un ordre croissant dans la partie droite de l.
À chaque itération, la première valeur du tableau (indice 0) est déplacée par échange avec ses voisins vers la droite jusqu’à ce qu’une valeur plus grande soit trouvée. Dans ce cas, c’est cette valeur la plus grande qui est déplacée vers la partie droite du tableau. Une boucle interne est utilisée pour appliquer ce processus jusqu’à ce qu’aucun échange ne puisse plus être effectué.
Écrivez votre script dans un nouveau fichier appelé bubble_sort.py. Assurez-vous que votre algorithme fonctionne correctement, comme vous l’avez fait dans un exercice précédent.
Une légère amélioration peut certainement être appliquée à votre algorithme pour réduire le nombre d’échanges. Essayez de trouver ce qui peut être amélioré et comparez les deux versions selon le temps qu’elles mettent à trier le même tableau. Écrivez votre solution dans un nouveau fichier appelé bubble_sort_2.py.
Correction
Cliquez ici pour révéler la réponse.
Voici un code possible qui implémente deux optimisations :
Introduire un drapeau pour détecter si la liste est déjà triée – Cela permet à l’algorithme de s’arrêter tôt si aucun échange n’est effectué pendant un passage, ce qui signifie que la liste est déjà triée.
Réduire la plage de la boucle interne – À chaque passage, le plus grand élément est placé à la bonne position, donc la plage de la boucle interne peut être réduite à chaque itération.
# Needed importsimport random
import time
# ConstantsN =10# Set the seedrandom.seed(42)
# Generate a random list of N numberslist_to_sort = [random.randint(0, 100) for i in range(N)]
print("Unsorted list:", list_to_sort)
# Get the current time# We are going to measure execution time for info# Here, we measure the process time rather than the elapsed timestart = time.process_time()
# Loop through the list to sort itfor i in range(len(list_to_sort)):
# Loop through the list to compare elementsfor j in range(len(list_to_sort) -1):
# Swap elements if they are not in the right orderif list_to_sort[j] > list_to_sort[j +1]:
list_to_sort[j], list_to_sort[j +1] = list_to_sort[j +1], list_to_sort[j]
# Get the current time after sorting# The difference will give us the execution timestop = time.process_time()
print("Sorted list in %f seconds"% (stop - start))
# Check that the list is indeed sortedi =1while i < N and list_to_sort[i] >= list_to_sort[i-1]:
i +=1print("Is the list sorted?", i == N)
print("Sorted list:", list_to_sort)
Une légère amélioration peut certainement être appliquée à votre algorithme pour réduire le nombre d’échanges. Essayez de trouver ce qui peut être amélioré et comparez les deux versions selon le temps qu’elles mettent à trier le même tableau. Écrivez votre solution dans un nouveau fichier appelé bubble_sort_2.py.
Voici un code possible qui implémente deux optimisations :
Introduire un drapeau pour détecter si la liste est déjà triée – Cela permet à l’algorithme de s’arrêter tôt si aucun échange n’est effectué pendant un passage, ce qui signifie que la liste est déjà triée.
Réduire la plage de la boucle interne – À chaque passage, le plus grand élément est placé à la bonne position, donc la plage de la boucle interne peut être réduite à chaque itération.
# Needed importsimport random
import time
# ConstantsN =10# Set the seedrandom.seed(42)
# Generate a random list of N numberslist_to_sort = [random.randint(0, 100) for i in range(N)]
print("Unsorted list:", list_to_sort)
# Get the current time# We are going to measure execution time for info# Here, we measure the process time rather than the elapsed timestart = time.process_time()
# Loop through the list to sort iti =0swapped =Truewhile i < len(list_to_sort) and swapped:
# Initialize flag to detect if any swap was made during this pass swapped =False# Loop through the list to compare elementsfor j in range(0, N - i -1):
# Swap elements if they are not in the right orderif list_to_sort[j] > list_to_sort[j +1]:
list_to_sort[j], list_to_sort[j +1] = list_to_sort[j +1], list_to_sort[j]
swapped =True# Next index i +=1# Get the current time after sorting# The difference will give us the execution timestop = time.process_time()
print("Sorted list in %f seconds"% (stop - start))
# Check that the list is indeed sortedi =1while i < N and list_to_sort[i] >= list_to_sort[i-1]:
i +=1print("Is the list sorted?", i == N)
print("Sorted list:", list_to_sort)
Comment pouvez-vous visualiser l’invariant ci-dessus en utilisant un débogueur pas à pas ?
Ajoutez un point d’arrêt à la fin de la boucle. Cela vous permettra de visualiser la liste triée à chaque itération, et de vérifier que l’invariant est respecté.
Voici un exemple de visualisation :
Itération (i + 1)
list_to_sort
1
[14, 3, 81, 35, 31, 28, 17, 94, 13, 94]
2
[3, 14, 35, 31, 28, 17, 81, 13, 94, 94]
3
[3, 14, 31, 28, 17, 35, 13, 81, 94, 94]
4
[3, 14, 28, 17, 31, 13, 35, 81, 94, 94]
5
[3, 14, 17, 28, 13, 31, 35, 81, 94, 94]
6
[3, 14, 17, 13, 28, 31, 35, 81, 94, 94]
7
[3, 14, 13,17, 28, 31, 35, 81, 94, 94]
8
[3, 13, 14, 17, 28, 31, 35, 81, 94, 94]
9
[3, 3, 14, 17, 28, 31, 35, 81, 94, 94]
Notez que la dernière itération n’est pas effectuée car la liste est déjà triée, ce qui rend l’invariant vrai pour le dernier indice également.